
Analysis
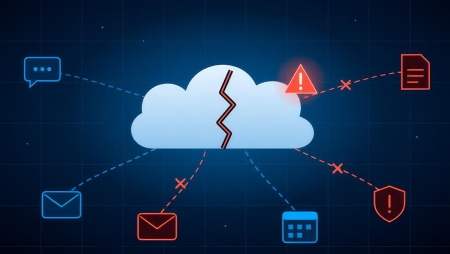
Uma falha de software introduzida em julho esteve na origem da interrupção global do Microsoft 365, a 12 de novembro. O incidente deixou mais de 80% dos servidores de gateway sem resposta
17/11/2026

|
A Microsoft revelou que a interrupção global dos serviços Microsoft 365, registada entre 12 e 13 de novembro, teve origem numa falha de software introduzida em julho de 2026. O problema permaneceu por detetar durante mais de três meses e acabou por desencadear uma falha em cascata que comprometeu mais de 80% dos servidores de gateway da infraestrutura. De acordo com a Bleeping Computer, que teve acesso ao relatório preliminar divulgado pela fabricante, o incidente resultou da combinação de três fatores: um erro de software anteriormente desconhecido, o aumento do tráfego após uma alteração automática na infraestrutura de rede utilizada pelo Microsoft Teams e a redução da capacidade disponível dos servidores. A interrupção afetou serviços como Outlook, Exchange Online, Teams e Copilot, impedindo milhões de utilizadores de acederem às caixas de correio eletrónico e provocando atrasos significativos na entrega de mensagens. O incidente começou às 16h20 de 12 de novembro, hora de Portugal continental, e prolongou-se durante quase 24 horas, até às 16h10 do dia seguinte. Falha permaneceu por detetar durante mesesDe acordo com a Microsoft, o erro foi introduzido numa atualização destinada aos servidores de gateway responsáveis pela gestão das ligações aos serviços Microsoft 365. Apesar de a atualização ter sido distribuída em julho e ter funcionado durante vários meses sem incidentes, continha uma falha que, perante determinadas condições de tráfego, podia sobrecarregar os servidores e deixá-los sem resposta. O problema não foi identificado durante os testes de carga realizados antes da implementação. A fabricante explica que os ambientes de teste utilizavam equipamentos com menor capacidade de processamento do que os servidores de produção. A falha manifestava-se de forma mais acentuada em equipamentos mais recentes, com um maior número de núcleos de processamento, devido à contenção de recursos entre processos. Esta diferença entre os ambientes de teste e de produção contribuiu para que o problema permanecesse desconhecido até à interrupção de novembro. A falha foi desencadeada depois de o Microsoft Teams ter passado a utilizar a infraestrutura de gateway que também suportava o Exchange Online, cerca de 15 horas antes do início do incidente. Esta alteração aumentou o tráfego nos servidores, numa altura em que aproximadamente 14% da capacidade da infraestrutura já se encontrava indisponível devido a um problema não relacionado. Embora a capacidade restante fosse suficiente para suportar as operações em condições normais, a combinação dos dois fatores acabou por desencadear o erro de software. À medida que os servidores deixavam de responder, os sistemas da Microsoft redirecionavam automaticamente o tráfego para outros equipamentos disponíveis. No entanto, estes acabaram por ficar igualmente sobrecarregados, propagando a interrupção pela infraestrutura. Segundo a fabricante, em menos de duas horas, a falha atingiu os servidores de gateway de forma generalizada, deixando mais de 80% dos equipamentos sem resposta. Os mecanismos de isolamento concebidos para impedir a propagação de problemas entre regiões também não conseguiram conter o incidente. Recuperação dificultada pelo tráfego acumuladoA Microsoft explica que a recuperação foi dificultada pelo volume de pedidos acumulados durante a interrupção. Sempre que os servidores afetados eram reiniciados, voltavam a receber um volume elevado de tráfego, o que provocava novas falhas e impedia a estabilização dos serviços. Embora plataformas como Teams, OneDrive e SharePoint tenham conseguido recorrer a infraestruturas alternativas e recuperar mais rapidamente, o Exchange Online não dispunha da mesma possibilidade naquele contexto. Depois de identificar o erro, a Microsoft desenvolveu uma correção e iniciou a sua distribuição pelos servidores afetados, permitindo recuperar progressivamente a estabilidade da infraestrutura. A fabricante confirmou o fim do impacto ativo nos clientes a 13 de novembro. Na sequência do incidente, a Microsoft afirma ter aumentado a capacidade dos servidores, melhorado os mecanismos de monitorização e introduzido salvaguardas adicionais para impedir que o redirecionamento de tráfego provoque novas falhas em cascata. A empresa continua a investigar as circunstâncias da interrupção e deverá apresentar um relatório final com conclusões e medidas adicionais. |
Receba todas as novidades na sua caixa de correio!
THREATS
Falha crítica no kernel Linux permite execução remota de código com privilégios root
THREATS
Mais de mil servidores GitLab continuam vulneráveis a falha crítica explorada em ataques
THREATS
Google desmantela botnet com 1,3 milhões de dispositivos Android e acusa fabricante de instalar malware
ANALYSIS
NCSC alerta para aceleração dos ciberataques com IA e prevê ransomware com malware inteligente até 2028
THREATS
Microsoft corrige mais de mil vulnerabilidades, incluindo zero-day explorada no Outlook
ANALYSIS
NCSC alerta para aceleração dos ciberataques com IA e prevê ransomware com malware inteligente até 2028
ANALYSIS
Extensão maliciosa do Claude Code no Cursor tentou instalar backdoor SSH persistente
ANALYSIS
“A shadow AI será um risco mais difícil de gerir do que o malware criado por cibercriminosos”
ANALYSIS
Cibersegurança mantém-se como principal preocupação entre os líderes de IT
ANALYSIS
Quase metade das empresas apresentam backups vulneráveis